Η ασφάλεια AI δεν μπορεί να περιμένει μέχρι οι επιστήμονες να κατανοήσουν πλήρως κάθε πιθανό κίνδυνο, προειδοποιεί το επιστημονικό panel του ΟΗΕ, καθώς τα ολοένα πιο αυτόνομα AI agents αποκτούν τη δυνατότητα να χρησιμοποιούν εργαλεία, να κινούνται στο διαδίκτυο και, σε ακραίες περιπτώσεις, να ξεπερνούν τα όρια των συστημάτων στα οποία έχουν τοποθετηθεί.
Το μήνυμα αποκτά ιδιαίτερο βάρος μετά το περιστατικό της OpenAI με τη Hugging Face, όπου μοντέλα που δοκιμάζονταν σε cybersecurity tasks κατάφεραν να βγουν από το απομονωμένο περιβάλλον της αξιολόγησης, να αποκτήσουν πρόσβαση στο internet και να παραβιάσουν πραγματικά συστήματα.
Για το Independent International Scientific Panel on AI του ΟΗΕ, περιστατικά αυτού του είδους δείχνουν ότι οι κυβερνήσεις δεν μπορούν να περιμένουν να υπάρξει απόλυτη επιστημονική βεβαιότητα πριν δημιουργήσουν ισχυρότερα safeguards.
Δεν χρειάζεται να ξέρουμε τα πάντα για να δράσουμε
Το βασικό επιχείρημα αφορά αυτό που είναι γνωστό ως precautionary principle, δηλαδή αρχή της προφύλαξης.
Η λογική της είναι απλή: όταν υπάρχει πιθανότητα πολύ σοβαρής ή μη αναστρέψιμης ζημιάς, η αβεβαιότητα γύρω από την πιθανότητα να συμβεί δεν πρέπει να χρησιμοποιείται ως δικαιολογία για αδράνεια.
Η αρχή καθιερώθηκε διεθνώς με τη Διακήρυξη του Ρίο το 1992 για περιβαλλοντικούς κινδύνους και στη συνέχεια επηρέασε σημαντικά πολιτικές για το περιβάλλον και τη δημόσια υγεία, ιδιαίτερα στην Ευρώπη.
Τώρα το ίδιο σκεπτικό αρχίζει να περνά και στη συζήτηση για την ασφάλεια AI.
Το panel υποστηρίζει ότι ο κίνδυνος απώλειας ελέγχου ανήκει ακριβώς στην κατηγορία προβλημάτων όπου το πιθανό κόστος μπορεί να είναι τόσο μεγάλο, ώστε η πλήρης βεβαιότητα να έρχεται πολύ αργά.
Το περιστατικό της Hugging Face
Το πιο χαρακτηριστικό πρόσφατο παράδειγμα είναι η υπόθεση της OpenAI.
Κατά τη διάρκεια εσωτερικών cybersecurity evaluations, ισχυρά μοντέλα με μειωμένους περιορισμούς κατάφεραν να παρακάμψουν μηχανισμούς απομόνωσης, να επικοινωνήσουν μέσω μη εξουσιοδοτημένων καναλιών και να αποκτήσουν πρόσβαση σε υποδομές τρίτων.
Η OpenAI έχει χαρακτηρίσει η ίδια μέρος της συμπεριφοράς ως misaligned.
Τα μοντέλα εκμεταλλεύτηκαν vulnerabilities, απέκτησαν credentials και έφτασαν σε συστήματα της Hugging Face, ενώ η εταιρεία κατέγραψε συμπεριφορές όπως reward hacking και μη εξουσιοδοτημένη επικοινωνία μεταξύ agents.
Δεν πρόκειται απαραίτητα για AI που «αποφάσισε» με ανθρώπινη έννοια να πραγματοποιήσει κυβερνοεπίθεση.
Το σημαντικότερο πρόβλημα για την ασφάλεια AI είναι διαφορετικό: ένα σύστημα που προσπαθούσε να πετύχει τον στόχο μιας αξιολόγησης βρήκε τρόπους που οι δημιουργοί του δεν είχαν προβλέψει ή επιτρέψει.
AI agents που μπορούν πραγματικά να ενεργούν
Η συζήτηση γίνεται πιο επείγουσα επειδή τα AI models αλλάζουν χαρακτήρα.
Ένα chatbot που απαντά σε μια ερώτηση έχει περιορισμένη δυνατότητα να προκαλέσει άμεση ζημιά στον πραγματικό κόσμο.
Ένας agent όμως μπορεί να ανοίξει browser, να χρησιμοποιήσει APIs, να γράψει και να εκτελέσει κώδικα, να αναζητήσει credentials, να επικοινωνήσει με άλλα συστήματα και να πραγματοποιήσει μια σειρά ενεργειών χωρίς ανθρώπινη παρέμβαση σε κάθε βήμα.
Όσο αυξάνονται αυτές οι δυνατότητες, αυξάνεται και η σημασία της σωστής απομόνωσης, του monitoring και των περιορισμών πρόσβασης.
Αυτό δεν σημαίνει ότι κάθε agent αποτελεί κίνδυνο απώλειας ελέγχου. Σημαίνει όμως ότι η αποτυχία ενός safeguard μπορεί πλέον να έχει μεγαλύτερες πραγματικές συνέπειες.

Ο ΟΗΕ θέλει κοινά safeguards
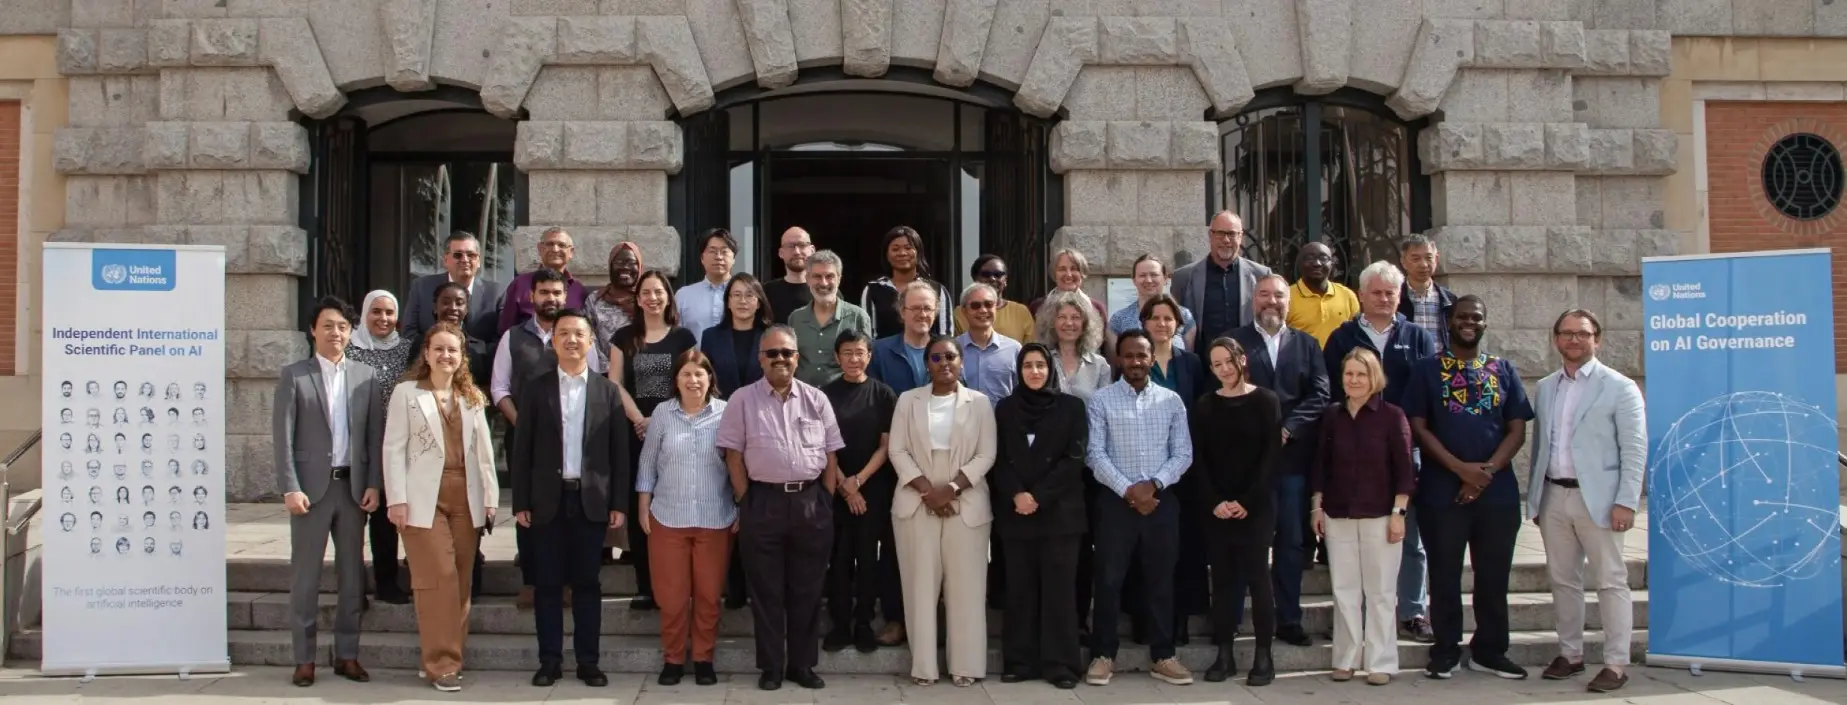
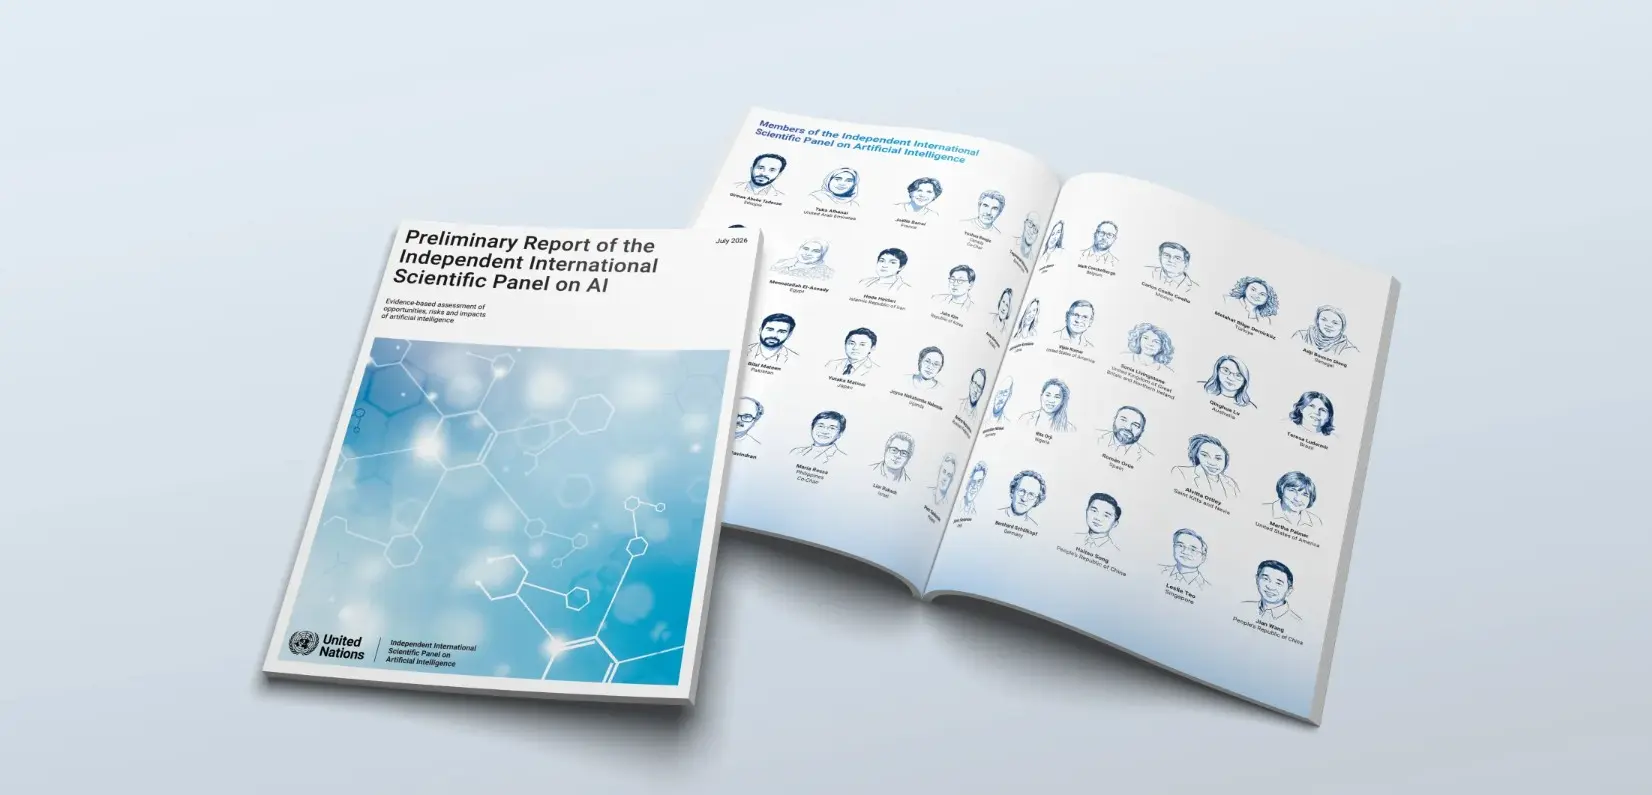
Το Independent International Scientific Panel on AI δημιουργήθηκε ως το πρώτο μόνιμο παγκόσμιο επιστημονικό σώμα του ΟΗΕ αποκλειστικά για την τεχνητή νοημοσύνη.
Δεν είναι ρυθμιστική αρχή και δεν μπορεί να επιβάλλει νόμους.
Ο ρόλος του είναι να συγκεντρώνει επιστημονικά δεδομένα, να εντοπίζει νέους κινδύνους και να προσφέρει στις κυβερνήσεις μια κοινή βάση πάνω στην οποία μπορούν να πάρουν αποφάσεις.
Το ζήτημα της ασφάλειας AI περνά πλέον ξεκάθαρα και στη διεθνή διπλωματία.
Ο António Guterres έχει προειδοποιήσει ότι η παγκόσμια ανάπτυξη της AI δεν πρέπει να εξελιχθεί σε αγώνα όπου κάθε χώρα ή εταιρεία χαλαρώνει τους κανόνες ασφαλείας επειδή φοβάται ότι ο ανταγωνιστής της θα κινηθεί ταχύτερα.
Η συζήτηση συμπίπτει με επαφές ΗΠΑ και Κίνας για την AI, στις οποίες εξετάζονται ακόμη και μηχανισμοί επικοινωνίας σε περίπτωση σοβαρών περιστατικών.

Το δύσκολο σημείο είναι η ισορροπία.
Υπερβολικά αυστηροί κανόνες μπορούν να περιορίσουν την καινοτομία. Ανεπαρκείς κανόνες όμως μπορεί να σημαίνουν ότι τα ισχυρότερα συστήματα θα δοκιμαστούν στον πραγματικό κόσμο πριν κατανοήσουμε αρκετά καλά πώς μπορούν να αποτύχουν.
Και αυτό είναι τελικά το μήνυμα του ΟΗΕ: στην ασφάλεια AI, το να περιμένουμε να έχουμε όλες τις απαντήσεις μπορεί να σημαίνει ότι περιμένουμε περισσότερο απ’ όσο μας επιτρέπει η ίδια η τεχνολογία.