Το EmbeddingGemma 2 είναι το νέο ελαφρύ AI model της Google DeepMind που έχει σχεδιαστεί για να τρέχει απευθείας σε κινητά, laptops και άλλες συσκευές, χωρίς να χρειάζεται κάθε αναζήτηση ή επεξεργασία δεδομένων να περνά από το cloud. Με 740 εκατ. παραμέτρους, μπορεί να δημιουργεί embeddings για κείμενο, κώδικα, εικόνες, video και ήχο μέσα στον ίδιο κοινό χώρο αναπαράστασης.
Αυτό επιτρέπει εφαρμογές που μέχρι σήμερα απαιτούσαν διαφορετικά μοντέλα για κάθε τύπο δεδομένων. Ένας χρήστης, για παράδειγμα, θα μπορούσε να αναζητήσει ένα συγκεκριμένο σημείο μέσα σε ένα video χρησιμοποιώντας μια φωνητική περιγραφή ή να βρει ένα ηχητικό αρχείο πληκτρολογώντας απλώς αυτό που θυμάται από το περιεχόμενό του.
Τι ακριβώς κάνει ένα embedding model
Το EmbeddingGemma 2 δεν δημιουργεί κείμενο όπως το Gemini ή το Gemma 4. Η δουλειά του είναι διαφορετική.
Μετατρέπει τα δεδομένα σε αριθμητικά vectors που αντιπροσωπεύουν το νόημά τους. Περιεχόμενο που είναι σημασιολογικά παρόμοιο τοποθετείται κοντά μέσα σε αυτόν τον μαθηματικό χώρο, ακόμη και όταν προέρχεται από διαφορετικές μορφές δεδομένων.
Έτσι, μια πρόταση, μια εικόνα, ένα απόσπασμα ήχου ή ένα frame από video μπορούν να συγκριθούν μεταξύ τους με βάση το περιεχόμενο και όχι απλώς λέξεις-κλειδιά ή filenames.
Η συγκεκριμένη τεχνολογία βρίσκεται πίσω από semantic search, recommendation systems και πολλά Retrieval-Augmented Generation συστήματα.
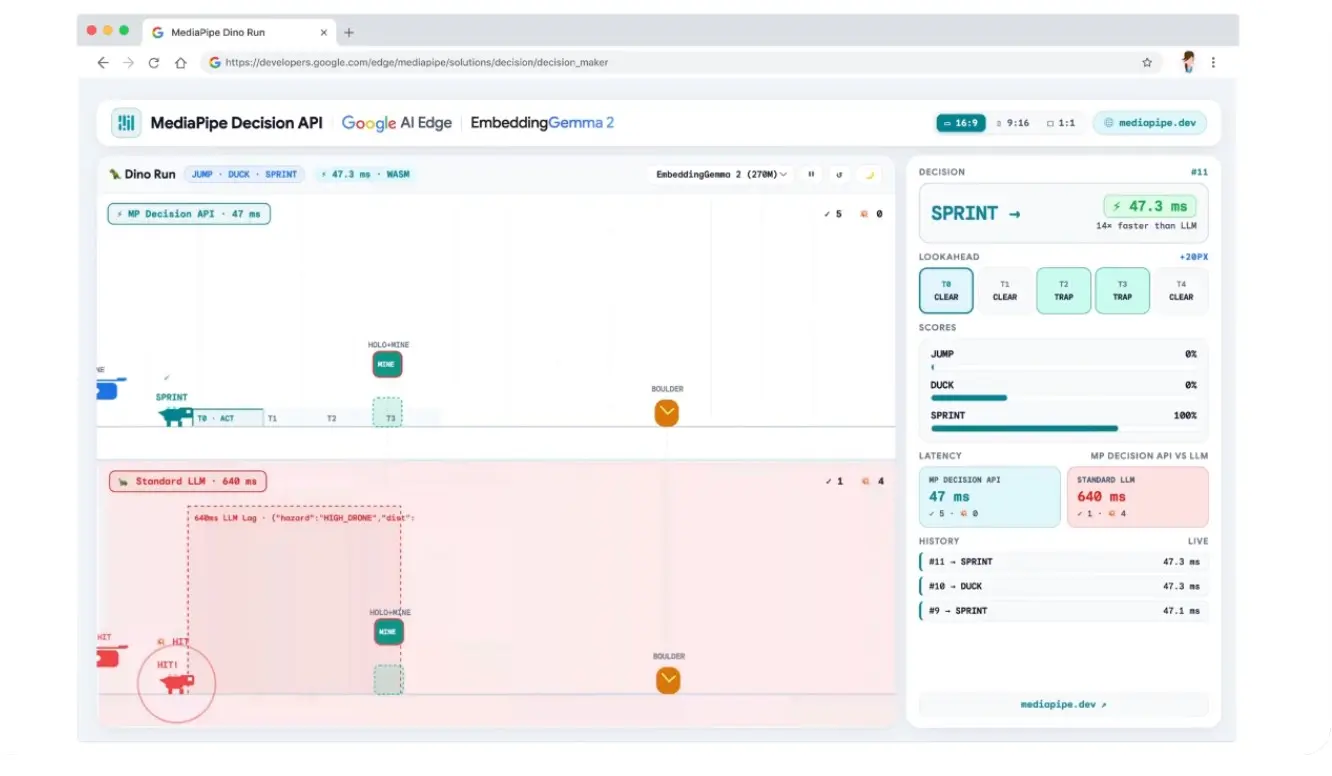
740 εκατ. παράμετροι με modular σχεδιασμό
Το πλήρες EmbeddingGemma 2 διαθέτει 740 εκατ. παραμέτρους, αλλά δεν χρειάζεται να φορτώνονται όλες σε κάθε περίπτωση.
Η text έκδοση χρησιμοποιεί περίπου 270 εκατ. παραμέτρους, ενώ προστίθενται ξεχωριστά vision encoder 170 εκατ. και audio encoder 300 εκατ. παραμέτρων όταν απαιτούνται οι αντίστοιχες δυνατότητες.
Αυτός ο modular σχεδιασμός επιτρέπει σε μια εφαρμογή που χρειάζεται μόνο text και code search να χρησιμοποιεί σημαντικά μικρότερο μοντέλο αντί να δεσμεύει πόρους για λειτουργίες που δεν χρησιμοποιεί.
Η Google αναφέρει ότι σε Pixel 11 Pro η quantized έκδοση χρειάζεται περίπου 191 MB ενεργής RAM για text-only χρήση και περίπου 567 MB για το πλήρες multimodal σύστημα.
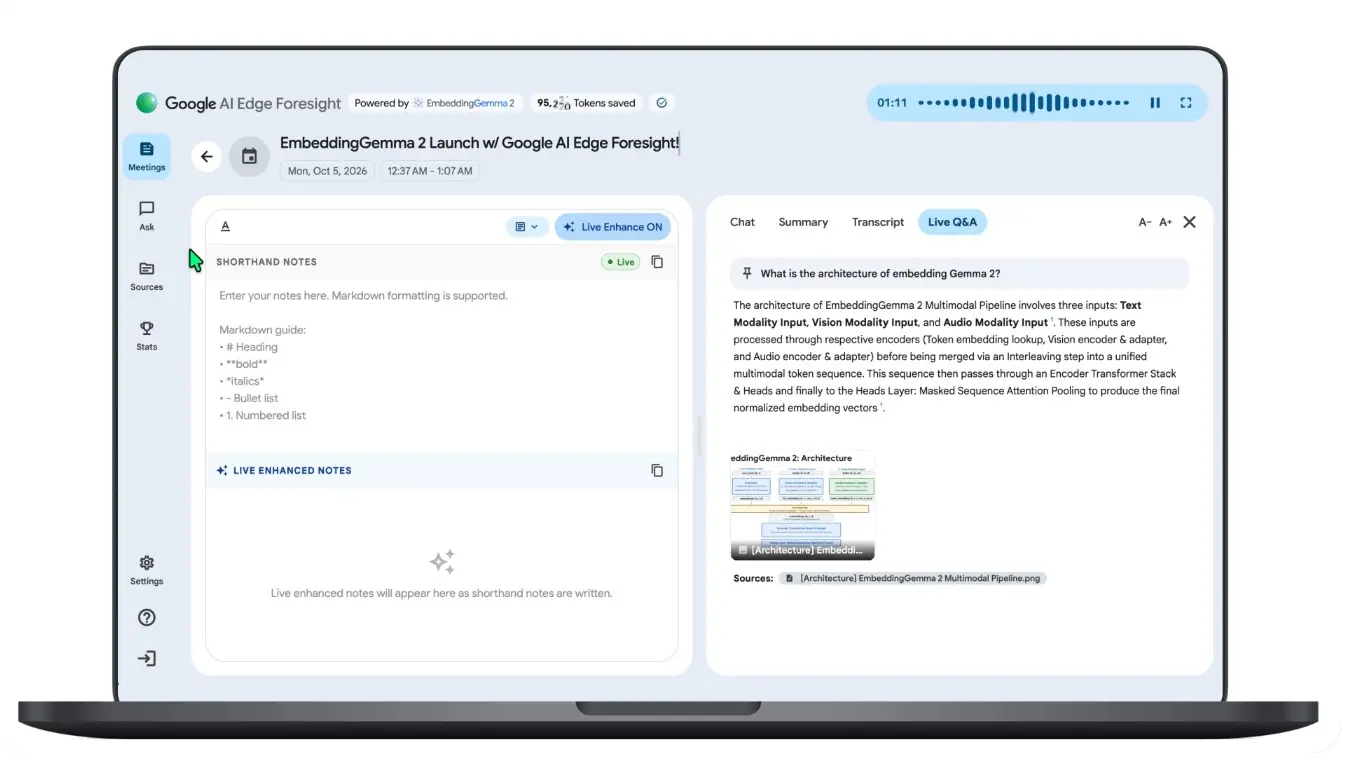
Όλα τα δεδομένα στον ίδιο χώρο
Το σημαντικότερο χαρακτηριστικό του EmbeddingGemma 2 είναι ότι text, εικόνες, ήχος και video καταλήγουν στον ίδιο embedding space των 768 διαστάσεων.
Αυτό καταργεί την ανάγκη δημιουργίας περίπλοκων pipelines στα οποία ένα audio model μετατρέπει πρώτα την ομιλία σε κείμενο, ένα image model παράγει περιγραφές και στη συνέχεια ένα τρίτο μοντέλο δημιουργεί τα embeddings.
Για εφαρμογές σε κινητά αυτό σημαίνει χαμηλότερο latency, μικρότερη κατανάλωση πόρων και, κυρίως, τη δυνατότητα επεξεργασίας προσωπικών δεδομένων τοπικά.
Ένα photo search app, για παράδειγμα, μπορεί θεωρητικά να αναζητά εικόνες χωρίς να ανεβάζει ολόκληρη τη βιβλιοθήκη φωτογραφιών σε απομακρυσμένο server.
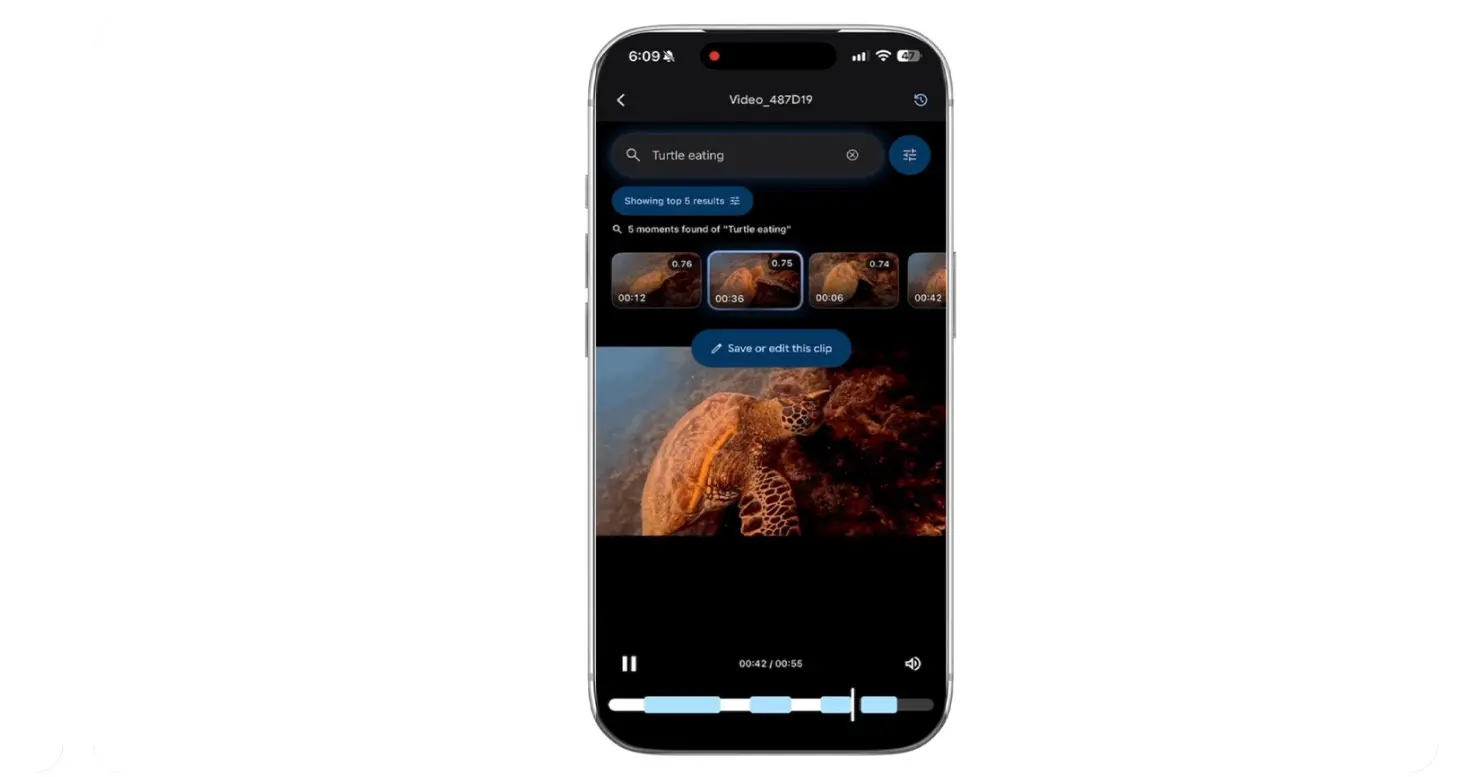
Έως έξι φορές μικρότερη αποθήκευση
Η Google χρησιμοποιεί επίσης Matryoshka Representation Learning, επιτρέποντας στους developers να μειώνουν τα embeddings από τις αρχικές 768 διαστάσεις στις 512, 256 ή ακόμη και 128.
Στις 128 διαστάσεις, ο απαιτούμενος χώρος αποθήκευσης μπορεί να μειωθεί έως έξι φορές.
Υπάρχει φυσικά συμβιβασμός στην ποιότητα. Στα επίσημα benchmarks, το αποτέλεσμα παραμένει σχετικά κοντά στην πλήρη έκδοση στις 256 διαστάσεις, ενώ η πτώση γίνεται περισσότερο αισθητή στα 128 dimensions, ιδιαίτερα στα multimodal workloads.
Μεγάλη βελτίωση στο code search
Ένας από τους τομείς όπου το EmbeddingGemma 2 εμφανίζει τη μεγαλύτερη πρόοδο είναι ο κώδικας.
Στο MTEB Code benchmark πέτυχε βαθμολογία 78,68 έναντι 68,76 του προηγούμενου EmbeddingGemma. Αυτό το κάνει ιδιαίτερα ενδιαφέρον για τοπική ευρετηρίαση repositories, semantic code search και retrieval systems που χρησιμοποιούνται από coding agents.
Η Google αναφέρει επίσης ισχυρές επιδόσεις σε image, visual document, video και audio retrieval, υποστηρίζοντας ότι το μοντέλο ανταγωνίζεται μεγαλύτερες εξειδικευμένες λύσεις. Οι συγκρίσεις αυτές, ωστόσο, χρειάζονται ανεξάρτητη αξιολόγηση σε πραγματικά workloads και όχι μόνο στα benchmarks της κυκλοφορίας.
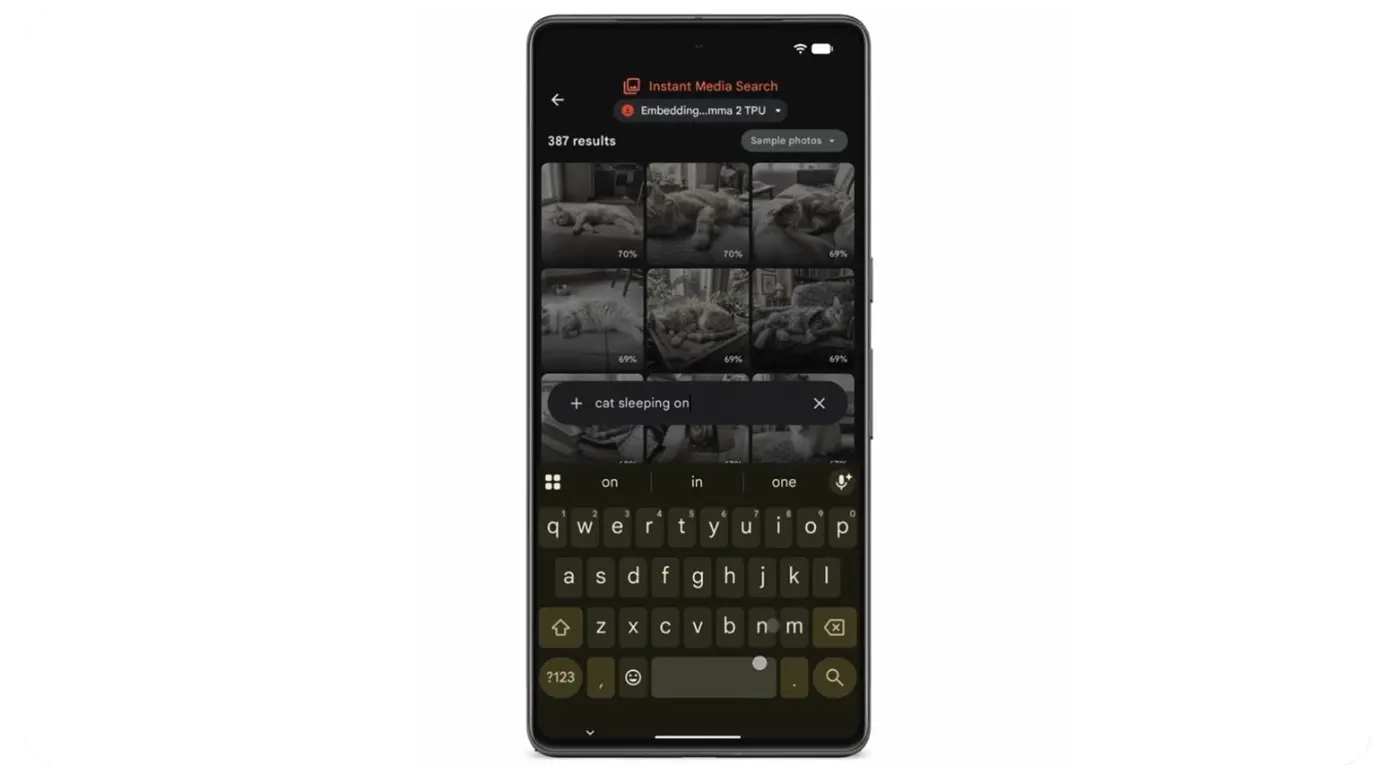
8K context και πλήρης λειτουργία χωρίς cloud
Το context window έχει αυξηθεί στις 8.192 tokens, τέσσερις φορές περισσότερο από την προηγούμενη γενιά.
Σύμφωνα με τη Google, αυτό αντιστοιχεί σε έως περίπου 5,5 λεπτά ήχου, 29 εικόνες ή 58 video frames, ενώ μπορούν να χρησιμοποιούνται και συνδυασμοί διαφορετικών modalities.
Το σημαντικότερο όμως είναι ότι όλα αυτά μπορούν να επεξεργάζονται τοπικά.
Σε συνδυασμό με ένα generative model όπως το Gemma 4, το EmbeddingGemma 2 μπορεί να χρησιμοποιηθεί για πλήρη on-device RAG pipelines, όπου η αναζήτηση σε προσωπικά αρχεία και η παραγωγή της απάντησης πραγματοποιούνται χωρίς τα δεδομένα να εγκαταλείπουν τη συσκευή.
Η Google διαθέτει το μοντέλο με άδεια Apache 2.0, ενώ τα weights είναι διαθέσιμα μέσω Hugging Face και Kaggle, με υποστήριξη από εργαλεία όπως LiteRT, MediaPipe, transformers, MLX, llama.cpp, Ollama και LM Studio.
Για τον τελικό χρήστη το EmbeddingGemma 2 μπορεί να μη γίνει ποτέ ένα αναγνωρίσιμο όνομα όπως το Gemini. Για τους developers, όμως, αντιπροσωπεύει κάτι ίσως πιο πρακτικό – έναν τρόπο να μεταφέρουν ισχυρό multimodal search, retrieval και RAG απευθείας στη συσκευή, με μικρότερο latency και μεγαλύτερο έλεγχο των προσωπικών δεδομένων.