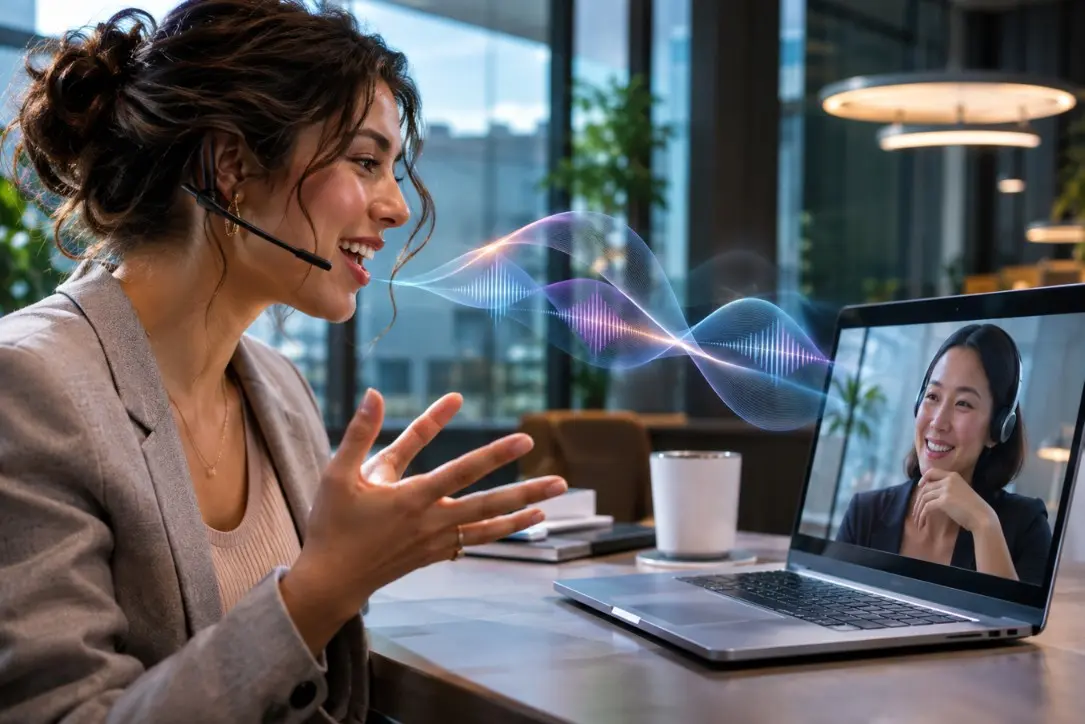
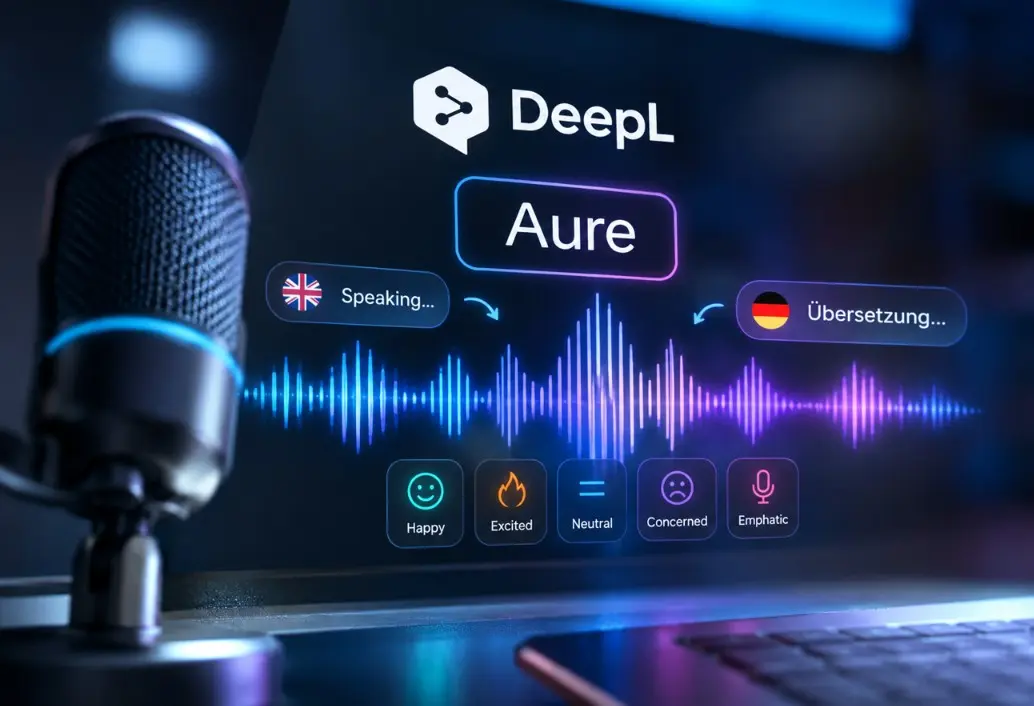
Η DeepL παρουσίασε το Aure, ένα νέο μοντέλο τεχνητής νοημοσύνης που επιχειρεί να κάνει τη φωνητική μετάφραση πολύ πιο φυσική, διατηρώντας όχι μόνο τα λόγια και τα χαρακτηριστικά της φωνής ενός ανθρώπου, αλλά και τον τρόπο με τον οποίο εκφράζεται. Η ανακοίνωση αφορά μια τεχνολογία που προσαρμόζει σε πραγματικό χρόνο τη μεταφρασμένη ομιλία στις αλλαγές του τόνου, της έντασης, της έμφασης και του ρυθμού. Στόχος είναι κάποιος που μιλά με ενθουσιασμό, δισταγμό ή αποφασιστικότητα να ακούγεται αντίστοιχα και στη γλώσσα της μετάφρασης.
Το DeepL Aure είναι ήδη διαθέσιμο μέσω του DeepL Voice, της πλατφόρμας που χρησιμοποιείται για ζωντανή μετάφραση επαγγελματικών συναντήσεων και συνομιλιών. Αρχικά υποστηρίζει οκτώ γλώσσες, χωρίς να περιλαμβάνονται τα ελληνικά. Η νέα τεχνολογία έρχεται δύο μήνες μετά την παρουσίαση των μοντέλων διατήρησης της φωνής που είχε ανακοινώσει η DeepL τον Σεπτέμβριο, προσθέτοντας ένα σημαντικό χαρακτηριστικό: η συνθετική φωνή δεν παραμένει πλέον σταθερή καθ’ όλη τη διάρκεια της συζήτησης, αλλά αλλάζει μαζί με τον άνθρωπο που μιλά.
Η μετάφραση δεν αφορά μόνο τις λέξεις
Στη συνηθισμένη φωνητική μετάφραση, το σύστημα αναγνωρίζει την ομιλία, μεταφράζει το περιεχόμενο και δημιουργεί ένα νέο ηχητικό αποτέλεσμα στην επιθυμητή γλώσσα.
Ακόμη και όταν η μετάφραση είναι σωστή, ένα σημαντικό μέρος της ανθρώπινης επικοινωνίας μπορεί να χαθεί. Η ειρωνεία, η αβεβαιότητα, η έμφαση σε μια συγκεκριμένη λέξη ή η αλλαγή του ρυθμού μιας πρότασης δεν μεταφέρονται πάντοτε στη νέα γλώσσα.
Έτσι, μια φράση που εκφωνείται με έντονη ανησυχία μπορεί να ακουστεί απολύτως ουδέτερη στη μετάφραση. Το ίδιο συμβαίνει όταν κάποιος εκφράζει ενθουσιασμό ή χρησιμοποιεί σαρκαστικό τόνο.
Με το Aure, η DeepL επιχειρεί να αντιμετωπίσει ακριβώς αυτό το πρόβλημα.
Το νέο μοντέλο αναλύει συνεχώς την αρχική ομιλία και το μεταφρασμένο περιεχόμενο, προσαρμόζοντας τη συνθετική φωνή ανάλογα με τις αλλαγές που παρατηρούνται στον τρόπο εκφοράς.
Για παράδειγμα, αν ένας ομιλητής ξεκινήσει μια παρουσίαση με ήρεμο τόνο και στη συνέχεια αυξήσει την ένταση για να υπογραμμίσει μια σημαντική πληροφορία, το Aure επιχειρεί να μεταφέρει αυτή τη διαφοροποίηση και στη μεταφρασμένη φωνή.
Η εταιρεία δίνει ιδιαίτερη έμφαση στις επαγγελματικές συζητήσεις, όπου η πειστικότητα μιας τοποθέτησης μπορεί να εξαρτάται εξίσου από το περιεχόμενο και από τον τρόπο που παρουσιάζεται.
Τι αλλάζει σε σχέση με την προηγούμενη τεχνολογία
Τον Σεπτέμβριο του 2026, η DeepL είχε παρουσιάσει νέες δυνατότητες που επιτρέπουν τη διατήρηση των ιδιαίτερων φωνητικών χαρακτηριστικών κάθε ομιλητή κατά τη μετάφραση.
Αντί να ακούγεται μια γενική συνθετική φωνή, το σύστημα μπορούσε να παράγει ομιλία που θύμιζε περισσότερο τον άνθρωπο που συμμετείχε στη συζήτηση.
Η συγκεκριμένη τεχνολογία χρησιμοποιούσε ένα αρχικό δείγμα ομιλίας για να καθορίσει τα χαρακτηριστικά της μεταφρασμένης φωνής.
Ο περιορισμός ήταν ότι αυτά τα χαρακτηριστικά παρέμεναν σε μεγάλο βαθμό σταθερά, ακόμη και όταν ο ομιλητής άλλαζε τον τόνο ή τον ρυθμό του.
Το DeepL Aure ακολουθεί διαφορετική προσέγγιση. Δεν περιορίζεται στο αρχικό δείγμα, αλλά συνεχίζει να επεξεργάζεται την ομιλία όσο εξελίσσεται η συζήτηση.
Με αυτόν τον τρόπο, επιχειρεί να διατηρήσει τόσο την αναγνωρίσιμη φωνητική ταυτότητα όσο και τη μεταβαλλόμενη εκφραστικότητα του ομιλητή.
Πρόκειται για σημαντική τεχνολογική διαφοροποίηση, καθώς η διατήρηση μιας φωνής δεν ταυτίζεται με τη σωστή αναπαραγωγή της συναισθηματικής και εκφραστικής της δυναμικής.
Πώς λειτουργεί το μοντέλο Aure
Για την ανάπτυξη του Aure, η DeepL συνδύασε διαφορετικές τεχνικές εκπαίδευσης μοντέλων τεχνητής νοημοσύνης, με στόχο τον διαχωρισμό τριών βασικών στοιχείων της ομιλίας: της ταυτότητας της φωνής, του προφορικού περιεχομένου και της προσωδίας.
Η προσωδία περιλαμβάνει χαρακτηριστικά όπως ο επιτονισμός, ο ρυθμός, η διάρκεια των παύσεων και η έμφαση που δίνεται σε συγκεκριμένα σημεία.
Ο διαχωρισμός αυτών των στοιχείων επιτρέπει στο σύστημα να μεταφέρει το λεκτικό περιεχόμενο σε άλλη γλώσσα, διατηρώντας περισσότερα χαρακτηριστικά από τον τρόπο εκφοράς του πρωτότυπου μηνύματος.
Σύμφωνα με την εταιρεία, το Aure χρησιμοποιεί επίσης τεχνικές reinforcement learning για τη βελτίωση της ποιότητας της παραγόμενης ομιλίας και της ακρίβειας της μετάφρασης.
Μία από τις δυσκολίες είναι η απομόνωση της φωνής από τον περιβάλλοντα θόρυβο, την ηχώ και τις παραμορφώσεις του ήχου.
Μια δεύτερη αφορά τις διαφορές μεταξύ γλωσσών. Η μεταφορά ενός εκφραστικού μοτίβου από τα αγγλικά στα ιαπωνικά, για παράδειγμα, δεν μπορεί να βασίζεται σε απλή αντιγραφή του τονισμού, επειδή οι γλώσσες έχουν διαφορετικές φωνητικές και ρυθμικές δομές.
Η DeepL υποστηρίζει ότι το μοντέλο μπορεί να προσαρμόζεται στον ομιλητή πριν ακόμη ολοκληρωθεί μια πρόταση.
Αυτό δεν σημαίνει ότι η τεχνητή νοημοσύνη γνωρίζει τι αισθάνεται πραγματικά ένας άνθρωπος. Το Aure επεξεργάζεται ακουστικά χαρακτηριστικά που συνδέονται με τον τρόπο έκφρασης και επιχειρεί να τα αποδώσει στη μετάφραση.
Πού χρησιμοποιείται και πώς ενεργοποιείται
Το νέο μοντέλο έχει ενσωματωθεί σε τρεις υπηρεσίες της DeepL.
Η πρώτη είναι το DeepL Voice for Online Meetings, που χρησιμοποιείται για πολύγλωσσες τηλεδιασκέψεις σε πλατφόρμες όπως Microsoft Teams, Zoom και Google Meet.
Η δεύτερη είναι το DeepL Voice for In-Person Conversations, το οποίο επιτρέπει τη ζωντανή μετάφραση συνομιλιών μεταξύ ανθρώπων που βρίσκονται στον ίδιο χώρο.
Η τρίτη αφορά το DeepL API for Voice, μέσω του οποίου επιχειρήσεις και προγραμματιστές μπορούν να ενσωματώνουν δυνατότητες φωνητικής μετάφρασης σε δικές τους εφαρμογές και υπηρεσίες.
Η DeepL διευκρινίζει ότι το Aure ενεργοποιείται αυτόματα στις υποστηριζόμενες γλώσσες, χωρίς να απαιτείται πρόσθετη ρύθμιση από τους χρήστες των αντίστοιχων υπηρεσιών.
Το DeepL Voice απευθύνεται κυρίως σε επιχειρήσεις και επαγγελματικές ομάδες. Δεν πρόκειται για μια νέα, ανεξάρτητη και δωρεάν εφαρμογή φωνητικής μετάφρασης για smartphones.
Για τη χρήση του σε επαγγελματικές συναντήσεις απαιτείται κατάλληλο πρόγραμμα DeepL Voice, ενώ η ανακοίνωση του Aure δεν συνοδεύτηκε από ξεχωριστή τιμολογιακή πολιτική.
Οι οκτώ γλώσσες και τι ισχύει για τα ελληνικά
Στην αρχική του διάθεση, το DeepL Aure υποστηρίζει αγγλικά, γερμανικά, ισπανικά, γαλλικά, ιταλικά, πορτογαλικά, ιαπωνικά και κορεατικά.
Η DeepL σχεδιάζει να επεκτείνει την υποστήριξη σε περισσότερες γλώσσες, χωρίς να έχει ανακοινώσει συγκεκριμένο χρονοδιάγραμμα.
Τα ελληνικά δεν περιλαμβάνονται στις οκτώ γλώσσες του νέου μοντέλου.
Αυτό, ωστόσο, δεν σημαίνει ότι το DeepL Voice δεν μπορεί να χρησιμοποιηθεί για συνομιλίες στα ελληνικά.
Σύμφωνα με την επίσημη τεκμηρίωση της εταιρείας, η ευρύτερη υπηρεσία υποστηρίζει τα ελληνικά ως γλώσσα ομιλίας, ως γλώσσα ζωντανών υποτίτλων και ως γλώσσα φωνητικής μετάφρασης.
Υπάρχει όμως μια σημαντική τεχνική διαφορά.
Η αναγνώριση ελληνικής ομιλίας πραγματοποιείται μέσω εξωτερικού παρόχου και προϋποθέτει την αντίστοιχη άδεια επεξεργασίας δεδομένων από τον διαχειριστή της υπηρεσίας.
Αντίστοιχα, η παραγωγή μεταφρασμένης ελληνικής φωνής γίνεται μέσω τεχνολογίας τρίτου παρόχου, χωρίς τη λειτουργία διατήρησης των ιδιαίτερων φωνητικών χαρακτηριστικών του ομιλητή που διαθέτουν ορισμένες άλλες γλώσσες.
Κατά συνέπεια, μια ελληνική επιχείρηση μπορεί να αξιοποιήσει τις υφιστάμενες υπηρεσίες DeepL Voice για πολύγλωσσες συναντήσεις, αλλά δεν έχει ακόμη πρόσβαση στις νέες δυνατότητες εκφραστικής μετάφρασης του Aure για την ελληνική γλώσσα.
Πώς ο Henry Cavill και η Google ένωσαν το gaming με το Movember
Η σημασία για την επικοινωνία και την προστασία δεδομένων
Η διατήρηση του εκφραστικού ύφους στη φωνητική μετάφραση έχει ιδιαίτερη αξία σε δραστηριότητες όπου ο τρόπος διατύπωσης ενός μηνύματος επηρεάζει την κατανόησή του.
Σε μια διαπραγμάτευση, για παράδειγμα, η έμφαση σε μία λέξη μπορεί να αλλάξει τον τρόπο με τον οποίο γίνεται αντιληπτή μια πρόταση. Σε μια επαγγελματική παρουσίαση, ο ενθουσιασμός ή η επιφυλακτικότητα ενός ομιλητή μεταφέρουν πληροφορίες που δεν αποτυπώνονται πλήρως στο γραπτό κείμενο.
Η DeepL συνδέει την ανάπτυξη του Aure με την προσπάθειά της να περιορίσει αυτές τις απώλειες κατά τη μετάφραση.
Σημαντικό μέρος της τεχνικής προσέγγισης αφορά και τη διαχείριση των δεδομένων φωνής. Η εταιρεία αναφέρει ότι τα δεδομένα των συνομιλιών, οι απομαγνητοφωνήσεις και οι μεταφράσεις δεν αποθηκεύονται μόνιμα για τις συγκεκριμένες λειτουργίες, αλλά διαγράφονται από τη μνήμη όταν ολοκληρώνεται η συνεδρία.
Η πρακτική αυτή σημαίνει ότι το σύστημα πρέπει να αναγνωρίζει και να προσαρμόζεται στα χαρακτηριστικά του ομιλητή σε κάθε νέα συζήτηση, αντί να χρησιμοποιεί ένα μόνιμο προσωπικό φωνητικό προφίλ.
Η παρουσίαση του DeepL Aure δείχνει μια σαφή τεχνολογική κατεύθυνση: η ζωντανή μετάφραση δεν περιορίζεται πλέον στην απόδοση των σωστών λέξεων, αλλά επιχειρεί να μεταφέρει περισσότερα από τα στοιχεία που κάνουν την ανθρώπινη ομιλία φυσική και εκφραστική.