


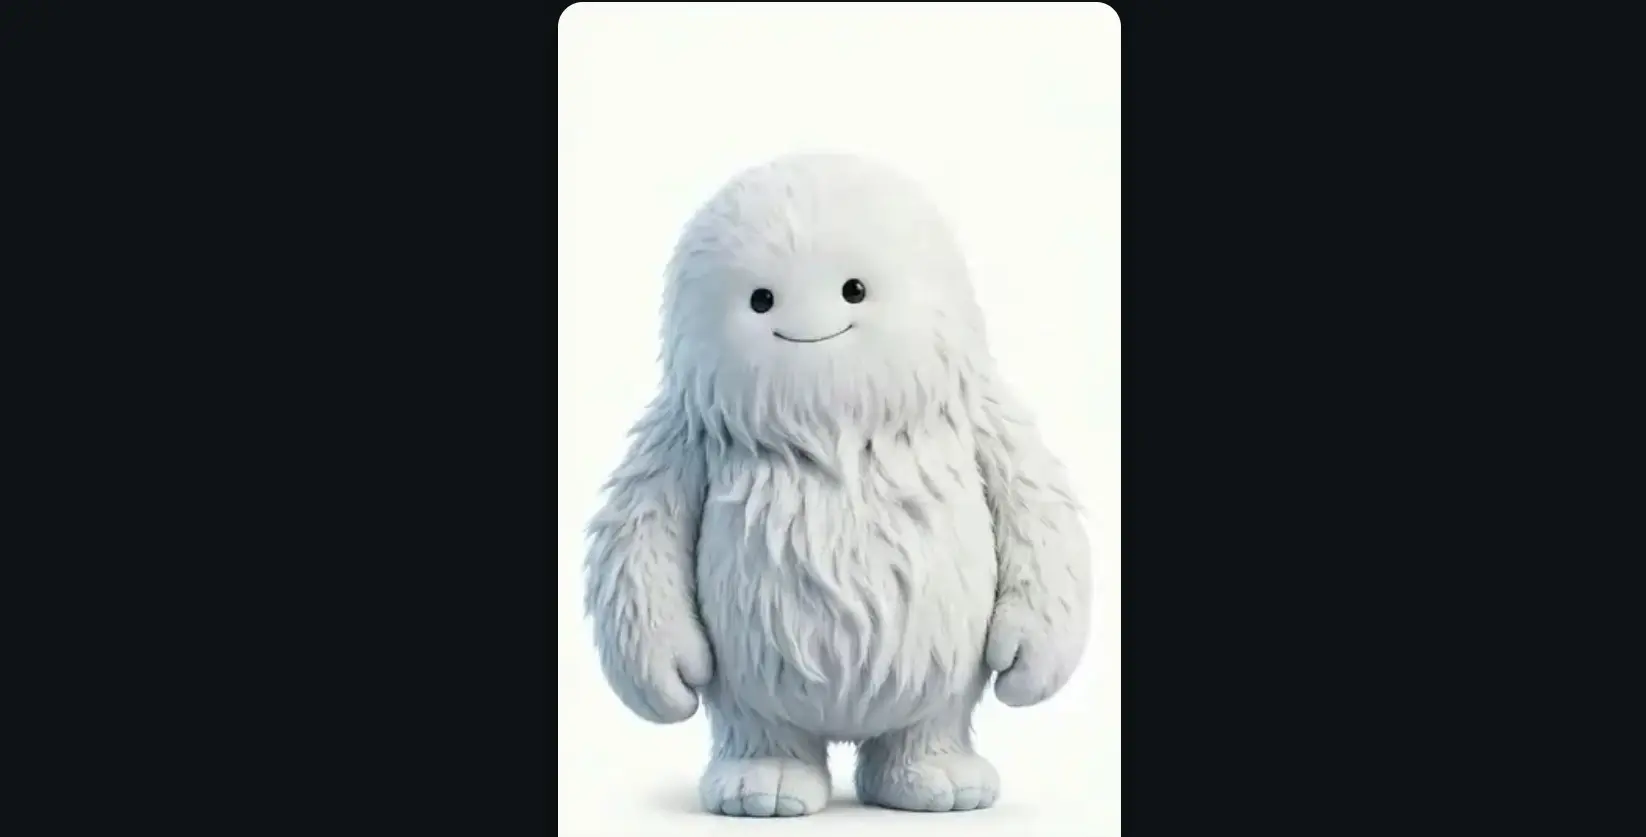
Το Muse Realtime Avatar είναι η τεχνολογία με την οποία η Meta θέλει να μετατρέψει τον προσωπικό AI agent της από μια φωνή σε μια ζωντανή, οπτική παρουσία. Το νέο σύστημα δημιουργεί σε πραγματικό χρόνο animated avatars που μιλούν, αλλάζουν εκφράσεις, κινούν το σώμα τους και παραμένουν οπτικά συνεπή όσο συνεχίζεται η συνομιλία.
Η τεχνολογία παρουσιάστηκε από τη Meta Superintelligence Labs στο πλαίσιο του Meta Connect 2026 και λειτουργεί μαζί με το Muse Realtime Voice. Η Meta αναφέρει ότι μπορεί να παράγει portrait video στα 25 fps με περίπου 870 ms καθυστέρηση μέχρι να αρχίσει να φτάνει στον χρήστη η συγχρονισμένη φωνητική και οπτική απάντηση. Πίσω από αυτό το αποτέλεσμα βρίσκεται ένα ιδιαίτερα επιθετικό optimization pipeline, το οποίο μειώνει μια διαδικασία 120 model evaluations σε μόλις δύο.
Από μία εικόνα σε ζωντανό avatar
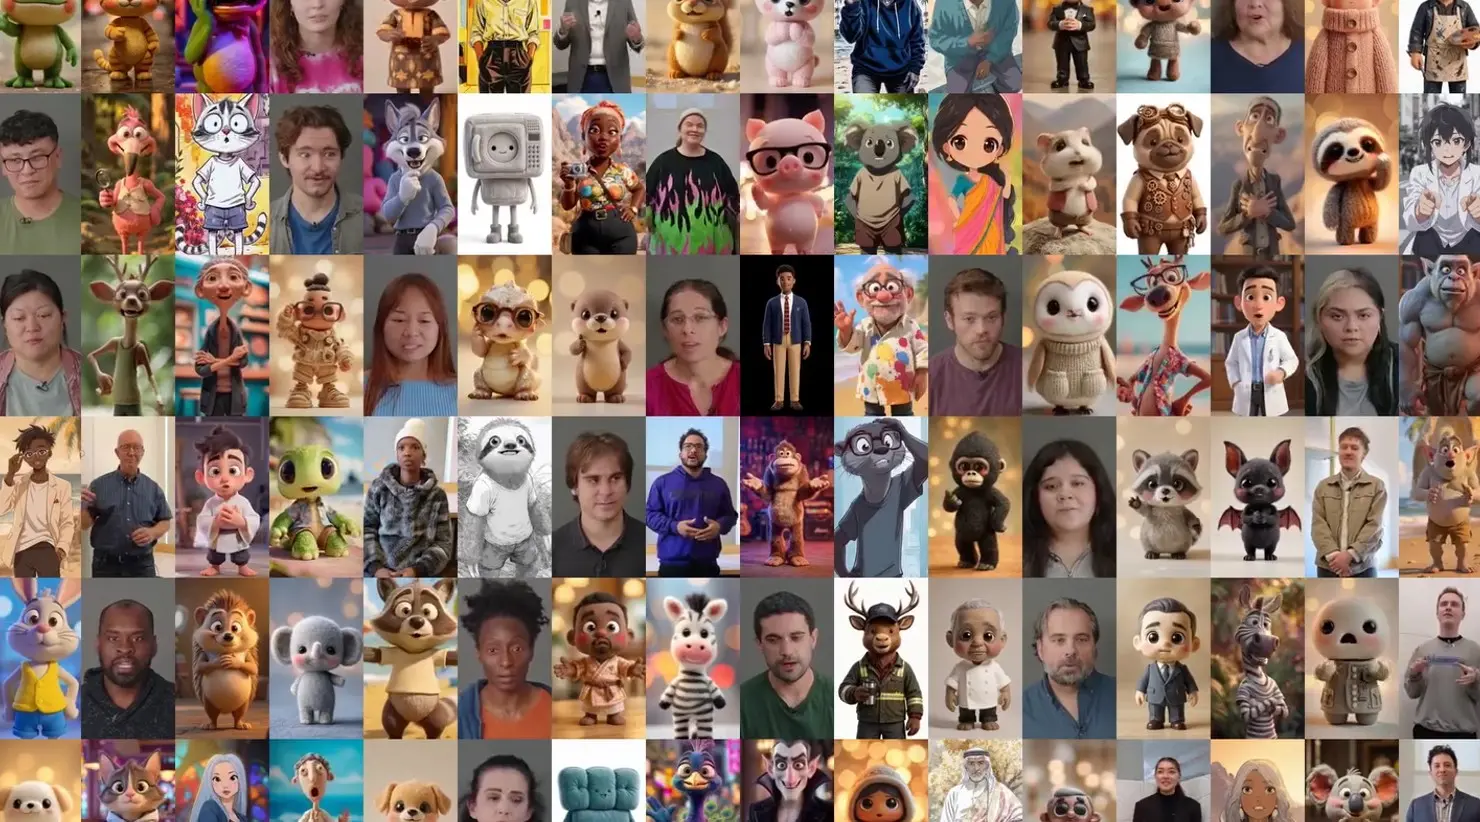
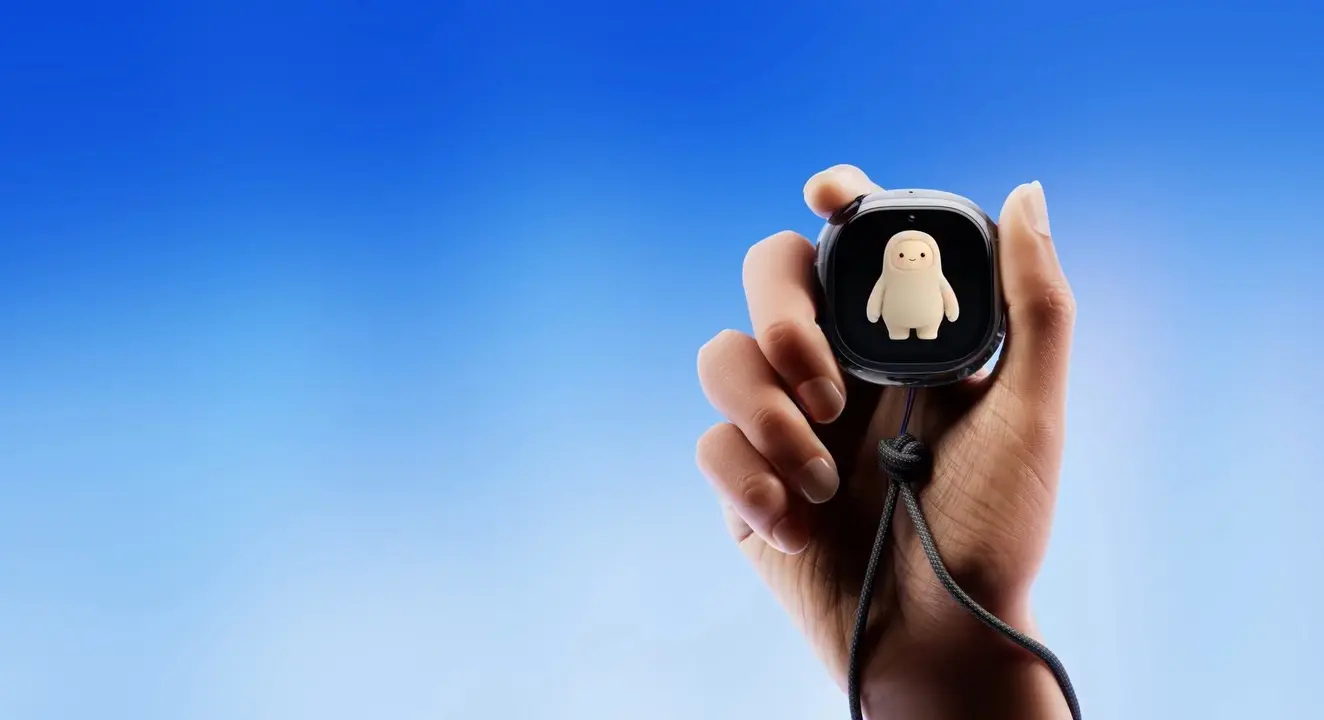
Το Muse Realtime Avatar μπορεί να ξεκινήσει από reference media που δίνει την εμφάνιση του χαρακτήρα.
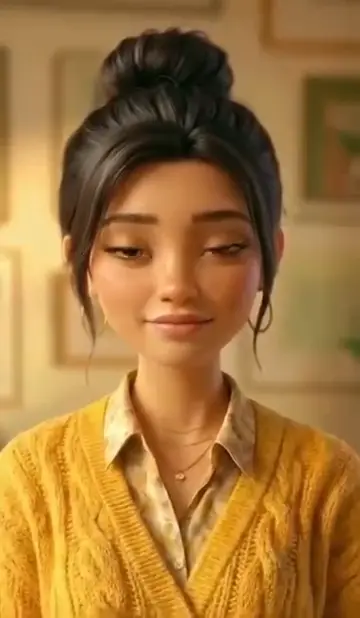
Αν πρόκειται για φωτογραφικό πορτρέτο, το μοντέλο μπορεί να δημιουργήσει μικρές εκφράσεις του προσώπου καθώς ο χαρακτήρας μιλά.
Σε μια ολόσωμη εικονογράφηση μπορεί να δημιουργήσει κινήσεις των χεριών, αλλαγές στη στάση του σώματος και άλλα gestures.
Η τεχνολογία δεν περιορίζεται μάλιστα σε ανθρώπους. Η Meta παρουσιάζει παραδείγματα με ζώα, illustrations και ακόμη και καθημερινά αντικείμενα που αποκτούν εκφραστικότητα χωρίς να χάνουν τα βασικά οπτικά χαρακτηριστικά τους.
Το δύσκολο σημείο δεν είναι απλώς να δημιουργηθούν μερικά δευτερόλεπτα animation. Είναι να παραμείνει ο χαρακτήρας ίδιος όσο μια συνομιλία συνεχίζεται για λεπτά.
Η φωνή και το video παράγονται από το ίδιο stream
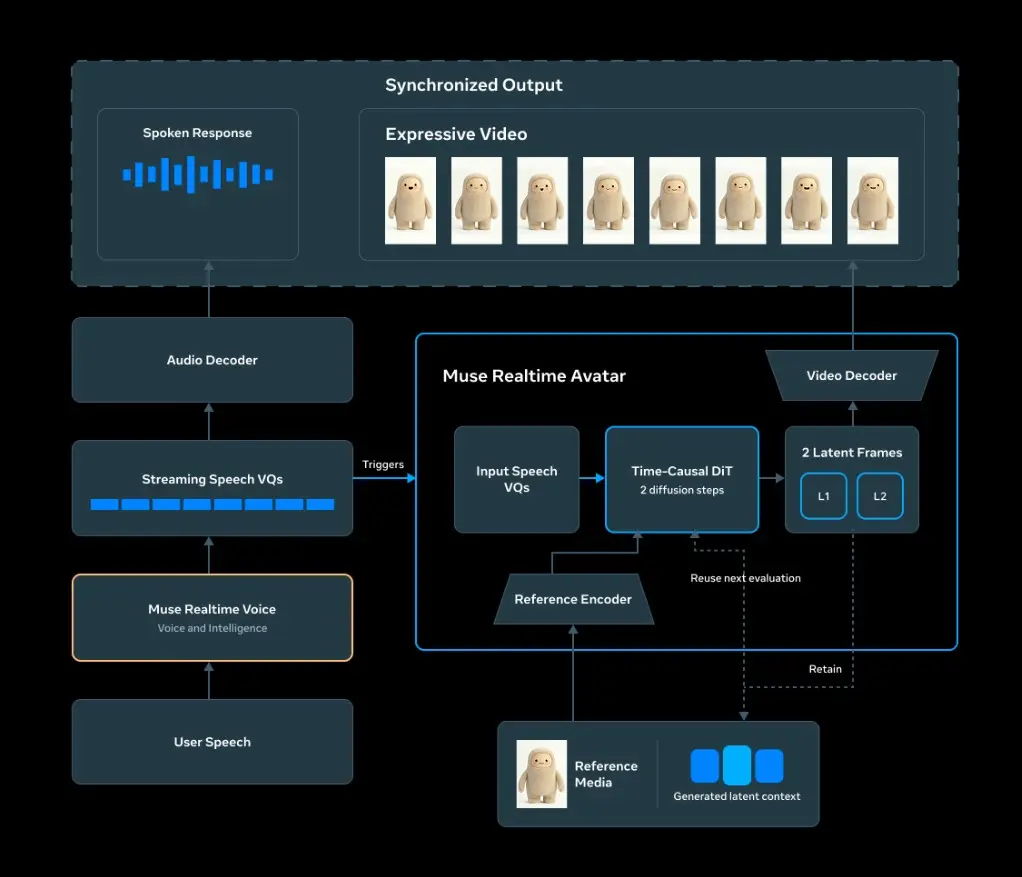
Η Meta έχει σχεδιάσει το Muse Realtime Voice και το Muse Realtime Avatar ως ενιαίο streaming σύστημα.
Το voice model παράγει speech tokens – VQs – που μεταφέρουν όχι μόνο το περιεχόμενο όσων λέει το AI, αλλά και πληροφορίες σχετικά με τον τρόπο που τα εκφέρει.
Ένας audio decoder μετατρέπει αυτά τα tokens σε φωνή.
Την ίδια στιγμή, το avatar model καταναλώνει το ίδιο token stream για να παράγει τις αντίστοιχες κινήσεις του προσώπου και του σώματος.
Αυτό είναι κρίσιμο για τον συγχρονισμό.
Αν η φωνή και το video δημιουργούνταν από εντελώς ανεξάρτητα pipelines, το σύστημα θα έπρεπε στη συνέχεια να προσπαθεί να συγχρονίσει στόμα, έκφραση και ομιλία.
Εδώ, αντίθετα, τα δύο outputs ξεκινούν από την ίδια πληροφορία.
Ένα Diffusion Transformer που δεν σταματά να δημιουργεί video
Στην καρδιά του συστήματος βρίσκεται ένα audio-driven Diffusion Transformer.
Το μοντέλο λαμβάνει τρεις βασικές κατηγορίες δεδομένων: το speech-token stream, την εικόνα αναφοράς και ένα rolling window από πρόσφατα video latents.
Δεν παράγει ολόκληρο το video εκ των προτέρων.
Δημιουργεί μικρά causal chunks. Μόλις ολοκληρωθεί ένα chunk, τα νεότερα generated latents μεταφέρονται ως context στο επόμενο.
Αυτή η διαδικασία επιτρέπει θεωρητικά στο Muse Realtime Avatar να συνεχίζει να παράγει video για όσο διαρκεί η συνομιλία χωρίς να χρειάζεται να κρατά στη μνήμη ολόκληρο το ιστορικό κάθε frame.
Το rolling context βοηθά επίσης το μοντέλο να θυμάται την εμφάνιση, τη στάση και τις κινήσεις του avatar.
Το μεγάλο πρόβλημα του AI video είναι το drift
Η real-time παραγωγή video έχει δύο αντικρουόμενες απαιτήσεις.
Πρέπει να είναι εξαιρετικά γρήγορη, αλλά ταυτόχρονα δεν πρέπει να αρχίζει να παραμορφώνει τον χαρακτήρα όσο περνά η ώρα.
Αυτό το φαινόμενο είναι γνωστό ως drift.
Μικρά λάθη σε ένα generated frame μπορούν να γίνουν input για το επόμενο, να συσσωρευτούν και σταδιακά να αλλάξουν πρόσωπα, ρούχα, αναλογίες ή κινήσεις.
Η Meta χρησιμοποιεί self-forcing ώστε το student model να εκπαιδεύεται πάνω στο δικό του generated context και όχι αποκλειστικά πάνω σε τέλεια training examples.
Με αυτόν τον τρόπο μαθαίνει να διαχειρίζεται τα ίδια μικρά λάθη που θα συναντήσει όταν λειτουργεί πραγματικά.
Από 120 model evaluations σε δύο
Εδώ βρίσκεται ίσως το πιο εντυπωσιακό τεχνικό στοιχείο.
Το αρχικό bidirectional teacher model χρησιμοποιεί 40 diffusion steps.
Σε κάθε step εφαρμόζεται three-way classifier-free guidance, κάτι που απαιτεί τρία model passes.
40 επί 3 σημαίνει συνολικά 120 model evaluations για κάθε chunk.
Αυτό είναι υπερβολικά αργό και ακριβό για ζωντανή συνομιλία.
Η Meta χρησιμοποιεί self-forcing και distribution matching distillation ώστε να μεταφέρει μεγάλο μέρος της ποιότητας του teacher σε ένα πολύ μικρότερο causal student.
Το τελικό student χρειάζεται μόλις δύο unguided evaluations.
Έτσι προκύπτει το «60x» που αναφέρει η Meta: 120 evaluations γίνονται 2.
Δεν σημαίνει ότι ο χρήστης βλέπει video 60 φορές γρηγορότερα. Πρόκειται συγκεκριμένα για 60 φορές λιγότερες model evaluations στο συγκεκριμένο στάδιο generation.
870 ms μέχρι να αρχίσει η απάντηση
Η Meta αναφέρει ότι το Muse Realtime Avatar παράγει video ανάλυσης 448×768 στα 25 frames ανά δευτερόλεπτο.
Η μετρούμενη καθυστέρηση είναι περίπου 870 ms από τη στιγμή που ο χρήστης σταματά να μιλά μέχρι να λάβει το πρώτο byte της συγχρονισμένης audio-video απάντησης.
Σε μία συνεδρία πάνω σε NVIDIA GB200, κάθε generation step παράγει οκτώ frames.
Στα 25 fps αυτά αντιστοιχούν σε 320 ms video, αλλά το μοντέλο χρειάζεται περίπου 20 ms για να τα δημιουργήσει.
Αυτό αντιστοιχεί σε περίπου 2,5 ms model time ανά frame και δίνει στο σύστημα αρκετό περιθώριο ώστε να παράγει το επόμενο κομμάτι πριν ολοκληρωθεί η αναπαραγωγή του προηγούμενου.
12 ζωντανά avatars σε μία GB200
Η πραγματική πρόκληση για τη Meta δεν είναι να τρέξει ένα εντυπωσιακό demo.
Είναι να υποστηρίξει εκατομμύρια χρήστες.
Για αυτό η εταιρεία αναφέρει ότι ανασχεδίασε σημαντικό μέρος της real-time inference υποδομής της.
Χρησιμοποιούνται persistent KV caches, memory-aware positional encodings, cache-aware routing και latency-aware dynamic batching.
Παράλληλα, εφαρμόζεται 4-bit quantization-aware training ώστε να μειωθεί το inference cost, μαζί με fused kernels και NVIDIA CUDA Graphs για χαμηλότερο memory traffic και μικρότερο scheduling overhead.
Η Meta συνεργάστηκε επίσης με την NVIDIA για optimizations στο forward pass.
Συνολικά, η εταιρεία υποστηρίζει ότι η νέα υποδομή αυξάνει κατά 8 φορές τη serving capacity σε σύγκριση με το two-step BF16 baseline.
Ένα GB200 μπορεί έτσι να εξυπηρετεί έως 12 ταυτόχρονες real-time video-generation sessions.
Meta απέναντι σε Runway και HeyGen
Η Meta δοκίμασε το Muse Realtime Avatar απέναντι στα Runway Characters και HeyGen LiveAvatar.
Οι testers πραγματοποίησαν συνομιλίες διάρκειας δύο έως τριών λεπτών με αντίστοιχα avatars και στη συνέχεια αξιολόγησαν χαρακτηριστικά όπως visual quality, synchronization, consistency και mannerisms.
Η Meta αναφέρει ότι το δικό της σύστημα είχε υψηλότερη συνολική προτίμηση.
Υπάρχει όμως σημαντική επιφύλαξη: το benchmark σχεδιάστηκε και δημοσιεύθηκε από την ίδια τη Meta.
Δεν πρόκειται για ανεξάρτητη αξιολόγηση, ενώ συνομιλίες δύο ή τριών λεπτών δεν αποδεικνύουν απαραίτητα ότι η οπτική συνοχή θα παραμένει ίδια σε πολύ μεγαλύτερες sessions.
Invisible watermark σε κάθε generated video
Τα real-time φωτορεαλιστικά avatars δημιουργούν προφανείς κινδύνους impersonation και deepfakes.
Η Meta αναφέρει ότι χρησιμοποιεί το Meta Video Seal για να ενσωματώνει αόρατο και ανθεκτικό watermark σε όλο το generated video.
Το watermark προστίθεται χωρίς επιπλέον latency και έχει στόχο να επιτρέπει την ανίχνευση περιεχομένου που έχει δημιουργηθεί από το σύστημα.
Δεν αποτελεί από μόνο του πλήρη λύση απέναντι στην κατάχρηση, αλλά προσθέτει provenance signal στο παραγόμενο υλικό.
Η εταιρεία επισημαίνει επίσης ότι το Muse απευθύνεται σε χρήστες άνω των 18 ετών.

Το AI agent αποκτά πλέον παρουσία
Το πιο ενδιαφέρον στοιχείο του Muse Realtime Avatar ίσως δεν είναι η ανάλυση, τα fps ή ακόμη και το sub-second response.
Είναι η μετατόπιση από ένα AI που βρίσκεται μέσα σε ένα chat box σε ένα AI με πρόσωπο, φωνή, σώμα και συνεχή οπτική παρουσία.
Μέχρι σήμερα, η μεγάλη πρόκληση των real-time avatars ήταν ότι είτε φαίνονταν πειστικά αλλά ήταν αργά, είτε ήταν γρήγορα αλλά έχαναν εύκολα τη συνοχή τους.
Η Meta υποστηρίζει ότι η νέα αρχιτεκτονική πλησιάζει αρκετά την ισορροπία μεταξύ των δύο ώστε ένα generative avatar να μπορεί να λειτουργεί σαν πραγματική video call.
Το αν οι χρήστες θα θέλουν πράγματι να κοιτούν έναν φωτορεαλιστικό AI χαρακτήρα ενώ μιλούν στον προσωπικό τους agent είναι διαφορετικό ερώτημα.
Τεχνικά, όμως, το Muse Realtime Avatar δείχνει προς μια εποχή όπου η δημιουργία video δεν θα σημαίνει πλέον «γράψε ένα prompt και περίμενε να παραχθεί ένα clip».
Θα συμβαίνει συνεχώς, frame προς frame, την ίδια στιγμή που μιλάμε.


